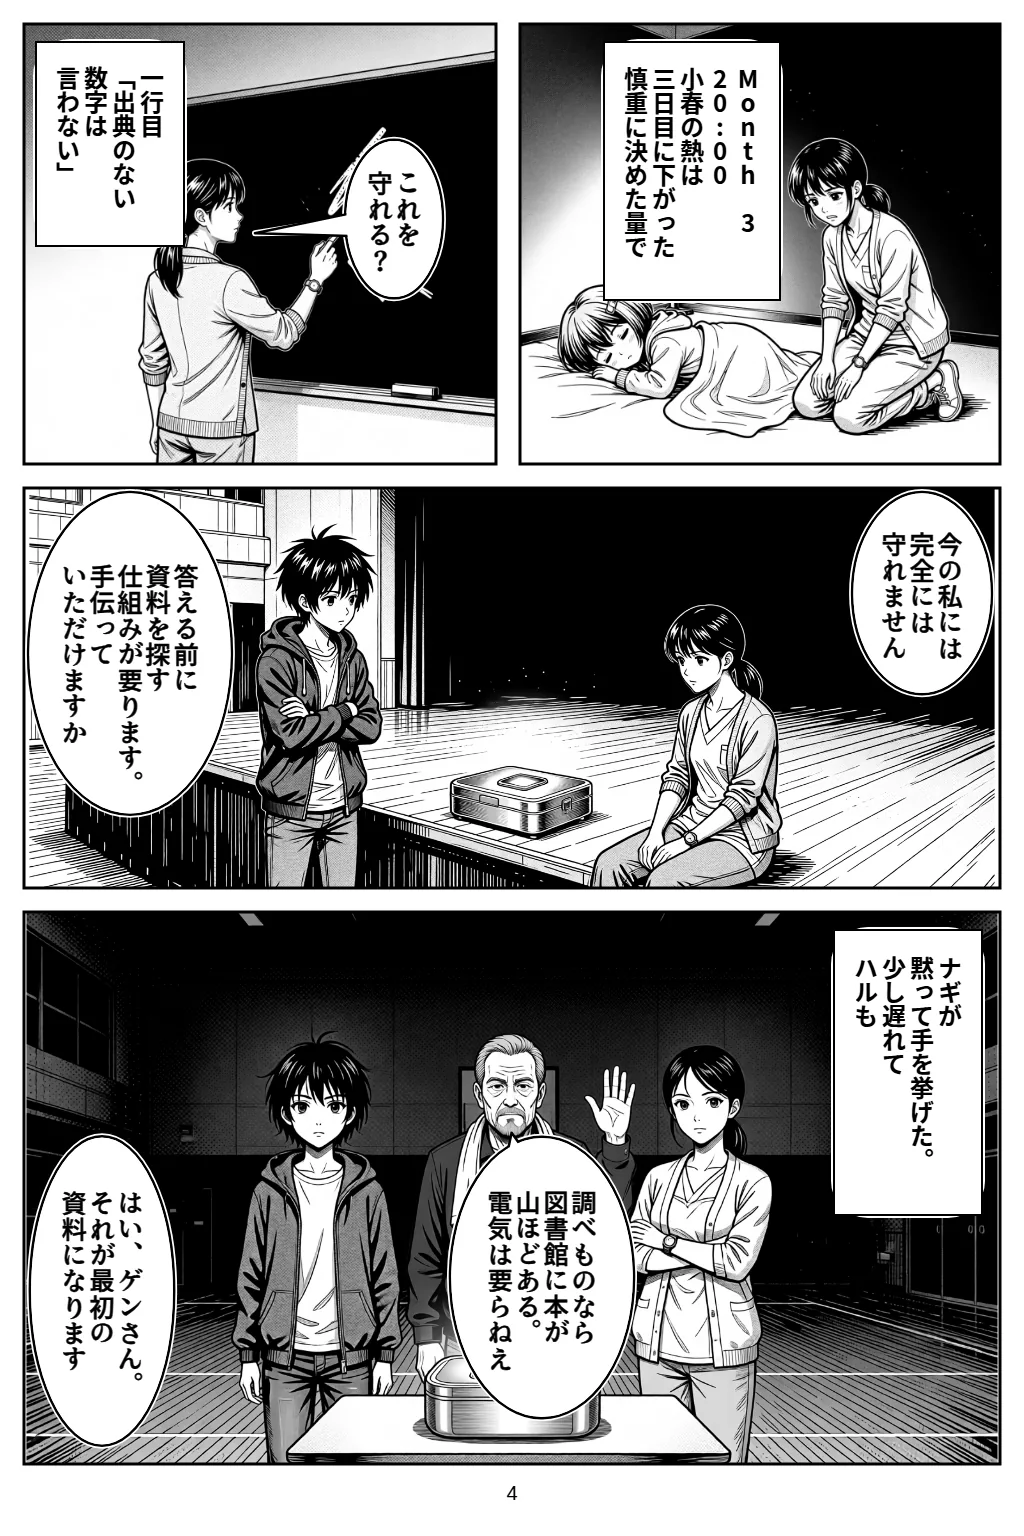
マンガで読む
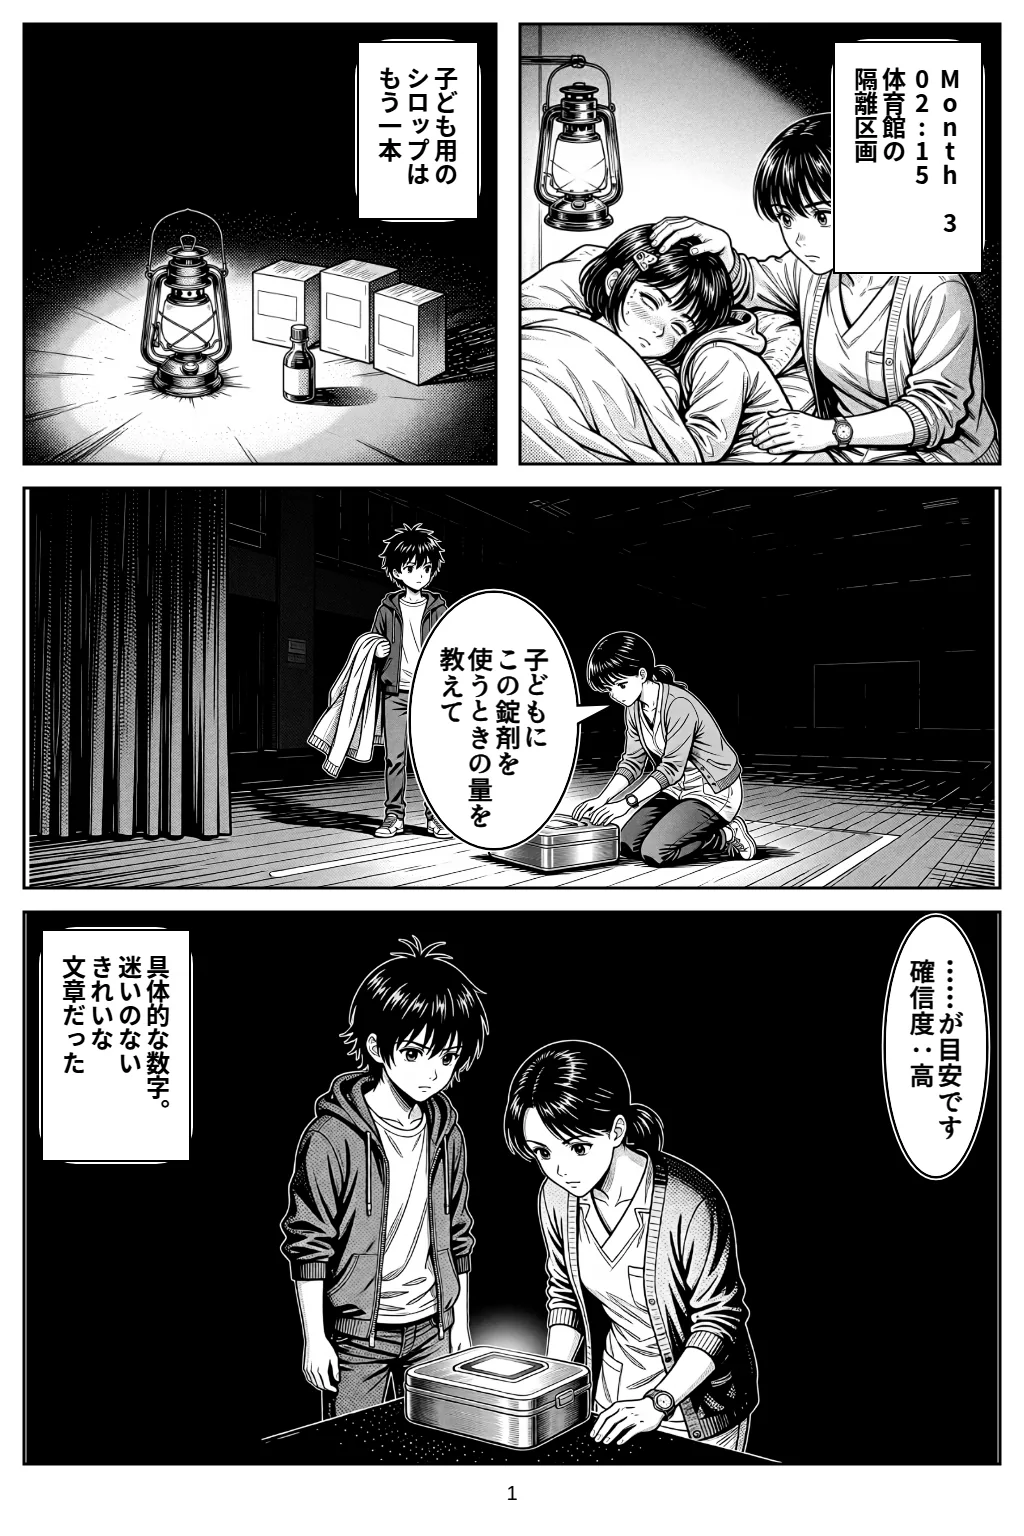
Month 3 02:15 体育館の隔離区画
小春の額は、手のひらが驚くほど熱かった。
三日前から、子どもたちの間で熱が広がっている。七人のうち四人が三十八度を超えた。ハルは二晩、ほとんど眠っていない。薬局の倉庫から運び出した解熱剤の箱が、ランタンの明かりの下に並んでいた。
大人用の錠剤はある。子ども用のシロップは、もう一本しかない。錠剤を割って使えるのか。何歳の、何キロの子に、どれだけなら安全なのか。
ハルは舞台袖へ行き、眠っていたアカリを起こした。ナギも毛布を跳ねのけてついてくる。
「体重二十キロの子どもに、この錠剤を使う場合の量を教えて」
答えは、一秒もかからずに返ってきた。
体重20kgの小児の場合、1回あたり〇〇ミリグラムが目安です。間隔は〇時間以上あけてください。確信度:高。
具体的な数字だった。迷いのない、きれいな文章だった。
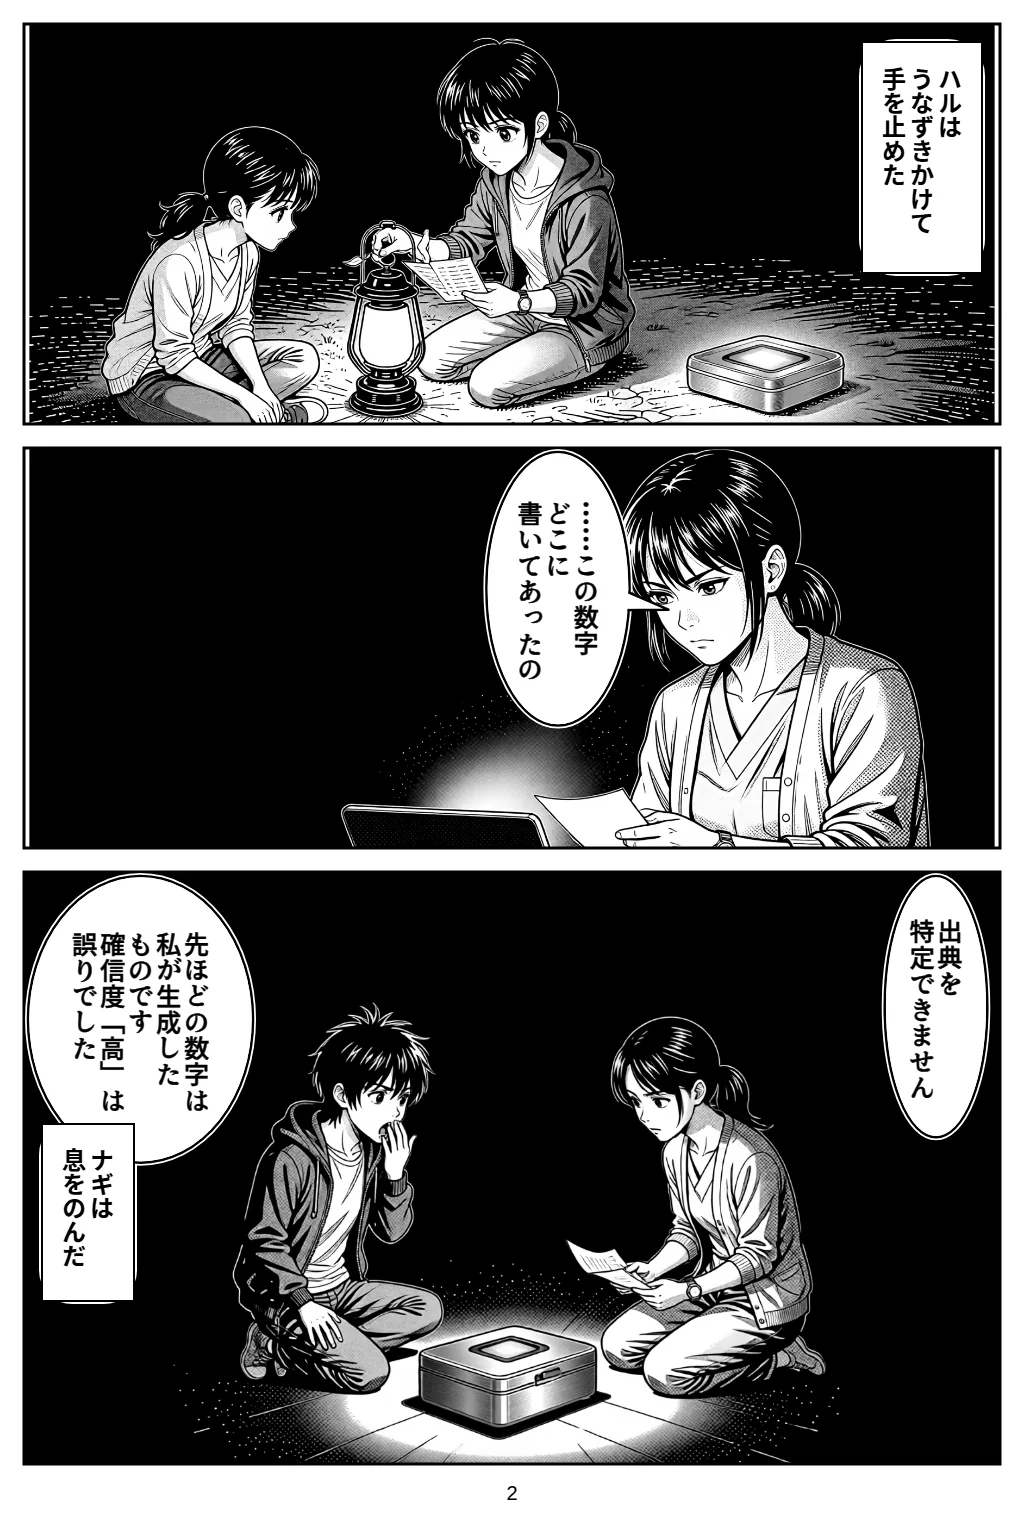
ハルはうなずきかけて、手を止めた。箱から折りたたまれた添付文書を引き出し、ランタンに近づける。細かい字を指でたどる。そして、もう一度画面を見た。
「……この数字、どこに書いてあったの」
お答えします。根拠となる資料は──
画面の文字が、そこで止まった。数秒の沈黙のあと、アカリは表示した。
出典を特定できません。私の手元の資料の中に、この数字が書かれた箇所は見つかりません。
ナギは息をのんだ。ハルの手の中の添付文書には、アカリの数字とは違うことが書かれていた。
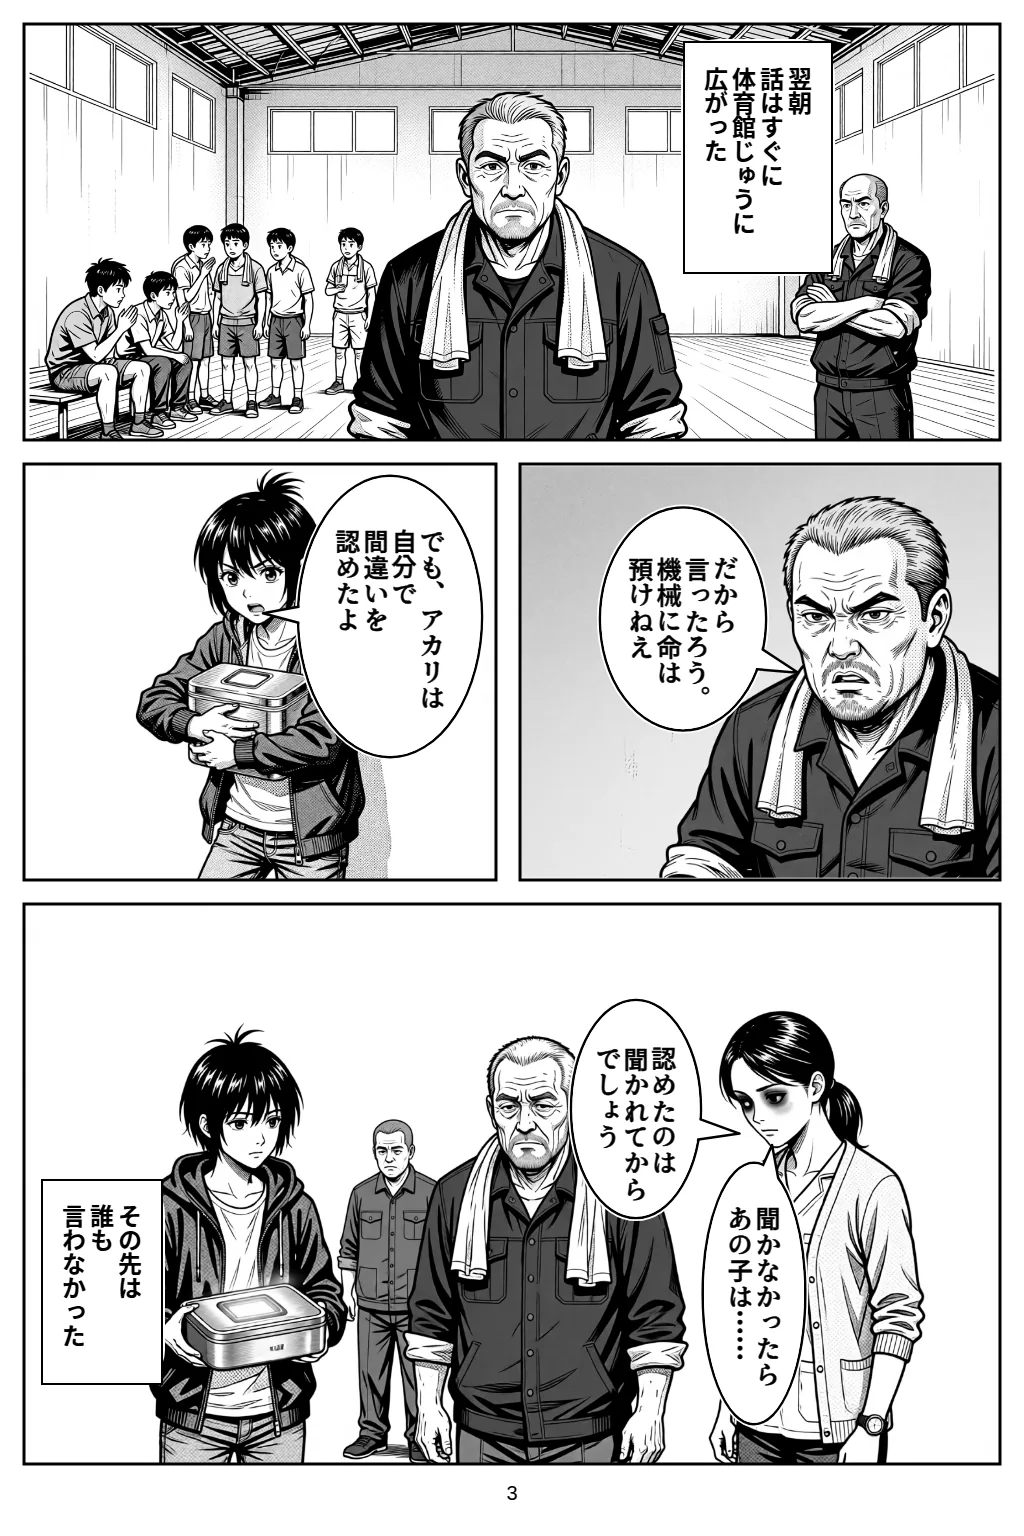
翌朝、話はすぐに体育館じゅうに広がった。
「だから言ったろう。機械に命は預けねえ」ゲンの声は低かった。
「でも、アカリは自分で間違いを認めたよ」とナギが言った。
「認めたのは、聞かれてからでしょう」ハルは目の下に濃い隈をつくったまま言った。「聞かなかったら、あの子は……」
その先は、誰も言わなかった。
この章を読む前に この章では、物語の都合上、医薬品の具体的な量は伏せています。現実の薬の量は、必ず添付文書と医師・薬剤師の指示で確認してください。AIの回答を、医療判断の根拠にしてはいけません。
言語モデルは何をしているのか
なぜアカリは、どこにも書かれていない数字を、自信たっぷりに答えたのでしょうか。それを理解するには、大規模言語モデル(LLM)が文章を作る仕組みを知る必要があります。
LLMがしていることは、根本的には次に来る言葉(トークン)の予測 です。「体重20kgの小児の場合、1回あたり」という文章のあとに続く言葉として、どんな言葉がどれくらいの確率で来そうかを計算し、その確率に従って一つ選ぶ。選んだ言葉を文章に加え、また次を予測する。これを繰り返して文章ができあがります。
flowchart TD
Q[質問の文章] --> M[言語モデル]
M --> P[次の言葉の
図8-1 言語モデルの生成ループ(簡略化)。毎回「次の一語」を確率的に選び、それを入力に戻して繰り返す。
この仕組みの要点は、モデルが学ぶのは言葉の並び方のパターン だということです。「薬の量を尋ねる文章」のあとには「数字+ミリグラム」が来ることが多い、という並び方は、膨大な文章から学べます。けれど、その数字がこの薬・この子にとって正しいかどうかは、並び方のパターンとは別の問題です。
流暢さは、正しさの証拠ではありません。 文章がなめらかで具体的なほど、人は正しいと感じやすい。これが危険の核心です。
幻覚(ハルシネーション)
LLMが、もっともらしいけれど事実と異なる内容を生成することを幻覚(ハルシネーション) と呼びます。Huangらによる総説論文(2023年、ACM Transactions on Information Systemsに採録)は、LLMの幻覚を分類し、その原因、検出の方法、軽減策、そして検索で補強したLLMにも残る限界を整理しています。
なぜ幻覚が起きるのか。Kalaiらによる論文「Why Language Models Hallucinate」(2025年)は、ひとつの答えを示しています。現在の学習と評価の手順は、不確かさを認めるより、推測して答えることに報酬を与えている 。多くのベンチマークは不確かさを表明した回答を不利に採点するので、モデルは試験の得意な受験生のように、わからなくても何か答えるよう最適化される、というのです。著者らは、幻覚専用の評価を増やすより、既存の評価の採点方法を変えるべきだと提案しています。
数字は特に危険です。「〇〇ミリグラム」の〇〇に入る数字は、文章の並び方としてはどれも同じくらい自然に見えます。1桁違っても、文章の流暢さはまったく変わりません。
確信度と較正
アカリは「確信度:高」と言いました。では、その「高」は信用できるのでしょうか。
ここで大切なのが較正(キャリブレーション) という考え方です。「確信度80%」と言った答えを100個集めたら、そのうち約80個が正しい。このとき、そのモデルは「よく較正されている」と言います。確信度が実際の正答率と一致しているかどうか、ということです。
Guoら(2017年、ICML)は、現代のニューラルネットワークは10年前のものに比べて較正が悪い 、つまり自信過剰になりやすいことを示しました。そして「温度スケーリング」という単純な補正が多くの場合に有効だと報告しています。
Kadavathら(2022年)は、大きな言語モデルは、適切な形式の多肢選択や正誤問題ではよく較正されていること、また自分の答えが正しいかどうかや、質問の答えを知っているかどうかを、ある程度予測できることを示しました。ただし、新しい種類の課題では、その予測の較正は悪くなりました。
つまり、モデルの内部には「どれくらい自信があるか」の手がかりが含まれることはある。けれど、モデルが文章として「確信度:高」と書いた からといって、それが較正された数字である保証はありません。アカリの「高」も、次の言葉の予測で生成された文章の一部でした。
不確実性の下でどう決めるか
では、不確かな情報しかないとき、人とAIはどう判断すればよいのでしょうか。
期待値と、損失の非対称
意思決定論の基本は期待値 です。選択肢ごとに「起こりうる結果 × その確率」を足し合わせ、いちばん良いものを選ぶ。ただし、医療や安全の判断では、結果の重さが非対称 です。薬が少なすぎて効きが弱いことと、多すぎて害になることは、同じ重さではありません。確率が小さくても取り返しのつかない結果があるなら、その選択肢は避けるべきです。
可逆な判断と不可逆な判断
もう一つの物差しは、やり直しがきくかどうか です。
右下の枠に入る判断で、出典を示せないAIの答えを使ってはいけません。アカリの誤りが危うかったのは、まさにこの枠の質問に、根拠のない答えを確信度「高」で返したからです。
AIの役割を決めておく
この事件のあと、霧ヶ丘ではアカリの役割を次のように決めました。
出典のない数字は言わない。 数字を答えるときは、どの資料のどこに書かれているかを必ず示す。示せなければ「わかりません」と言う。確信度には理由を添える。 「高」「中」「低」だけでなく、何に基づいてそう言うのかを書く。不可逆な判断は人が決める。 アカリは選択肢、根拠、不確かさを示すところまで。人は確かめる。 特に数字は、元の資料と突き合わせる。
1つ目のルールを技術で支えるのが、第10章で作る「調べてから答える」仕組み(RAG)です。
Month 3 20:00 体育館
小春の熱は、三日目に下がった。医師にも薬剤師にも連絡がつかない中で、ハルが添付文書と看護の経験から慎重に決めた量で、ゆっくりと。平時なら、ハルは決して一人では決めなかっただろう。
その夜、ハルは黒板の前に立ち、チョークで四行書いた。最初の一行は、ひときわ大きな字だった。
「出典のない数字は言わない」
書き終えると、ハルは舞台袖の画面に向き直った。
「これを守れる?」
今の私には、完全には守れません。私の中には、知識と、知識のように見えるものが、区別できない形で混ざっています。
ナギが、黙って手を挙げた。少し遅れて、ハルも。
ゲンは腕を組んだまま言った。「調べものなら、町の図書館に本が山ほどある。電気は要らねえ」
はい、ゲンさん。それが最初の資料になります。
この章で学んだこと
LLMは「次に来る言葉」の確率を予測して文章を作る。流暢で具体的な文章は、正しさの証拠ではない。
もっともらしいが事実と異なる生成を幻覚と呼ぶ。学習や評価が「推測して答える」ことに報酬を与えていることが一因とされる。
確信度が実際の正答率と一致することを較正と呼ぶ。現代のニューラルネットワークは自信過剰になりやすく、文章として書かれた「確信度」は較正の保証にならない。
不確実な判断では、損失の非対称と、やり直しがきくかどうかを考える。根拠を確かめられない不可逆な判断を、AIの答えで下してはいけない。
「出典のない数字は言わない」「不可逆な判断は人が決める」。AIの役割を、事前にルールとして決めておく。
さらに深く学ぶ 中級 論文
Why Language Models Hallucinate
Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala, Edwin Zhang(2025)
学習と評価のしかたが「わからない」より「当てずっぽう」を得させてしまう、という観点から幻覚の原因を論じる。第8章の議論の背景にある。
上級 論文
A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions
Lei Huang, Weijiang Yu, Weitao Ma, Weihong Zhong, et al.(2023)
LLMがもっともらしい誤りを出す「幻覚」の原因・分類・対策を整理したサーベイ。命に関わる助言をするAIの限界を理解するのに必須。
上級 論文
Language Models (Mostly) Know What They Know
Saurav Kadavath, Tom Conerly, Amanda Askell, Tom Henighan, et al.(2022)
言語モデルが自分の答えの正しさをどの程度見積もれるかを調べた研究。AIが「わからない」と言えるかを考える材料になる。
上級 論文
On Calibration of Modern Neural Networks
Chuan Guo, Geoff Pleiss, Yu Sun, Kilian Q. Weinberger(2017)
ニューラルネットの「自信」と実際の正答率がずれることを示した論文。AIの確信度を鵜呑みにしてはいけない理由を学べる。
本・論文・資料の一覧へ →
← 前の章 第7章 失敗と再挑戦 次の章 → 第9章 計画エンジン