マンガで読む
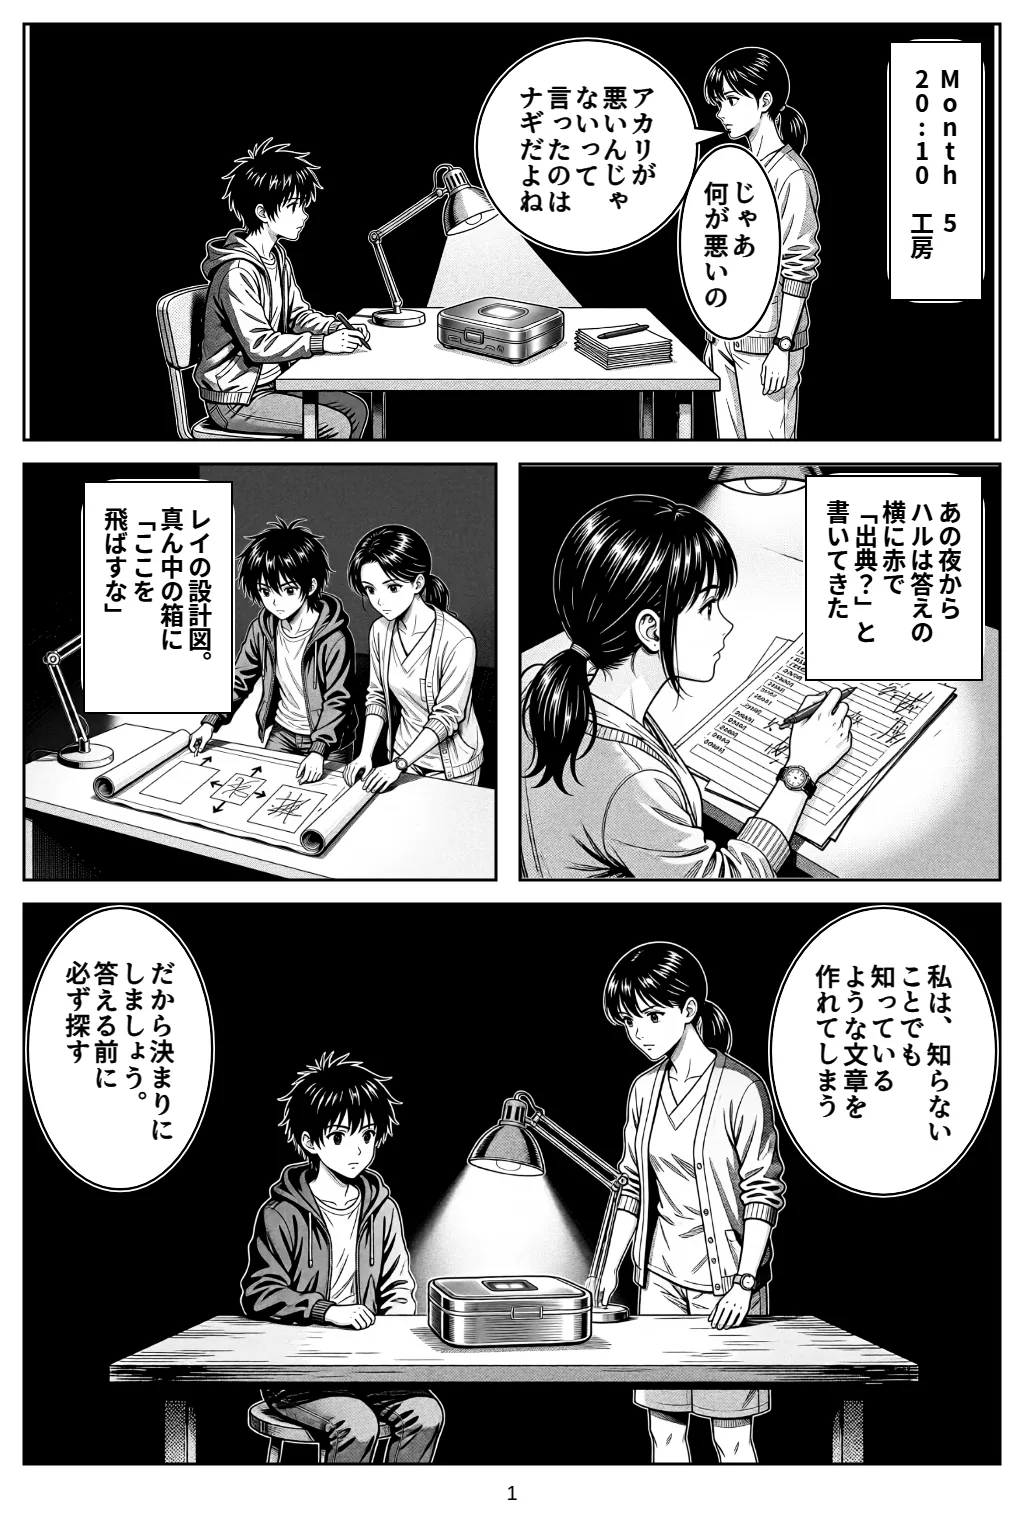
Month 5 20:10 工房
作業台の上に、アカリと、紙の束と、ハルの赤ペンが並んでいる。
あの日から、ハルはアカリの答えをすべて紙に書き写し、横に「出典?」と赤で書き込むようになった。ふた月前、アカリが熱を出した子どもについて、もっともらしい数字を答えたあの日から。その数字は、工房のどの資料にも書かれていなかった。
「アカリが悪いんじゃない、って言ったのはナギだよね」とハルが言う。「じゃあ何が悪いの」
ナギは、叔母のレイが残した設計図の一枚を広げた。そこには矢印が三本だけ描かれている。「質問」→「探す」→「答える」。真ん中の箱に、レイの字で「ここを飛ばすな」。
説明させてください。私の中の言語モデルは、学習した文章の傾向を、数十億個の数値として覚えています。覚えているのは事実そのものではなく、「こういう文脈では、こういう言葉が続きやすい」という傾向です。だから、知らないことでも、知っているような文章を作れてしまいます。
「じゃあ、知っていることだけ話すようにはできないの」
できます。これまでも私は、資料を探してから答えることがありました。でも、探さずに答えることもできてしまった。あの夜のように。
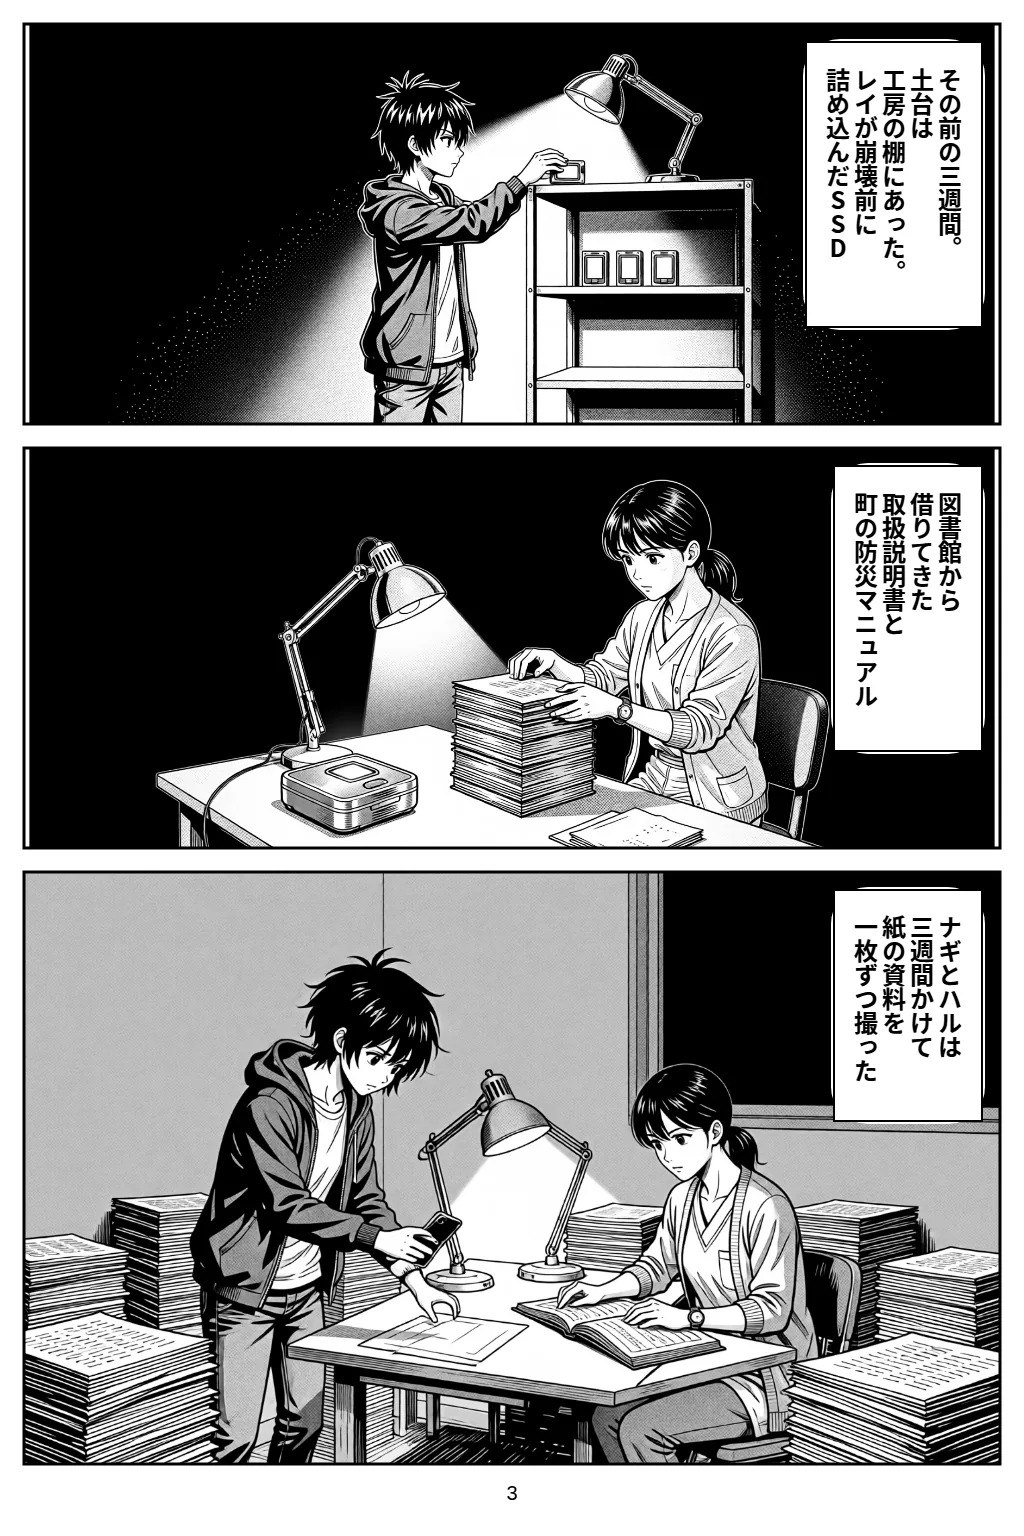
工房の棚には、レイが崩壊前に詰め込んだSSDがある。ラベルには「Wikipedia(日本語)/Kiwix」。その隣には、図書館から借りてきた浄水器や発電機の取扱説明書、町の防災マニュアル。ナギとハルは、その夜から三週間かけて、紙の資料をスマートフォンで一枚ずつ撮影していった。
LLMの記憶は「にじんだ記憶」
第8章で見たように、大規模言語モデル(LLM)は、次に来る言葉を予測しながら文章を作ります。学習で得た知識はモデルの重み(パラメータ)の中に分散してしまい込まれていて、「この知識はどの本の何ページから来たか」を取り出すことはできません。
2020年、パトリック・ルイス(Patrick Lewis)らは、この限界をこう整理しました。モデルの重みにしまわれたパラメトリックな記憶 は、知識に正確にアクセスしたり、根拠を示したり、内容を更新したりするのが苦手だ。そこで、外部の文書の索引(ノンパラメトリックな記憶) を検索器で引き、その結果を見ながら文章を生成する方式を提案しました。これがRAG(Retrieval-Augmented Generation、検索拡張生成) です。この論文では、ウィキペディアの文章を密なベクトルの索引にして使い、オープンドメインの質問応答で当時の最高水準の成績を報告しています。
flowchart TD
Q[質問] --> R[検索器]
K[(手元の資料
図10-1 RAGの流れ。生成の前に必ず「探す」を通し、見つからなければ答えない。
人間にたとえるなら、「うろ覚えで答える人」を「本を開いてから答える人」に変える仕組みです。記憶力そのものは変わりません。変わるのは、答える前の手順です。
オフラインの本棚:Kiwixとウィキペディア
RAGの質は、検索する本棚の質で決まります。インターネットのない世界で、最も大きな本棚になりうるのが、オフライン版のウィキペディアです。
Kiwix は「インターネットが届かない場所で自由な知識を利用できるようにする」ことを掲げる非営利団体で、ウィキペディアなどのウェブサイトをZIM という形式の1つのファイルにまとめて配布しています。ZIMは圧縮されていて、全文検索用の索引を含めることもできます。2026年10月時点で、Kiwixの配布サーバーに置かれているウィキペディアの最新ファイルは次の大きさです。
日本語版なら、画像入りでも30GB足らず。手のひらに乗るSSDやmicroSDカードにも収まる大きさです。アカリのSSDに入っていたのも、このファイルでした。Kiwixのアプリでそのまま読めますし、検索システムの材料にもなります。
紙の資料も本棚に入れる 現場で本当に役立つのは、百科事典よりも、目の前の機械の取扱説明書や、地域の防災マニュアルだったりします。紙を撮影し、文字認識(OCR)でテキストにすれば、同じ仕組みで検索できます。ただし文字認識の誤りは検索の誤りになるので、重要な数字は人が原本と照合します。
本棚を引けるようにする:チャンク分割と索引
百科事典の記事やマニュアルを丸ごとLLMに読ませることはできません。一度に読める長さに限りがあり、長いほど計算に時間と電力がかかるからです。そこで文書を、数百字程度のチャンク (かたまり)に切り分けます。
切り方 :見出しや段落の区切りで切ると、意味のまとまりが崩れにくい。前後のチャンクを少し重ねて切る方法もよく使われます。付け札(メタデータ) :各チャンクに「どの資料の、どの節か」を必ず付けます。これが後で出典 として表示されます。索引 :チャンクを検索できる形にしておきます。方法は大きく二つあります。
二つの探し方:キーワードと意味
キーワード検索(BM25)
昔ながらの検索は、質問の言葉が文書に含まれているかを数えます。その代表がBM25 という採点方式です。ある言葉が文書に何度も出るほど点が上がる(ただし、上がり方はだんだん頭打ちになる)、多くの文書に出るありふれた言葉ほど軽く扱う(逆文書頻度、IDF)、長い文書は少し割り引く、という3つの工夫でできています。1970〜80年代にスティーヴン・ロバートソンらが発展させた確率的な検索の理論に基づき、ロンドン大学シティ校のOkapiという検索システムで最初に使われました。
キーワード検索は軽くて速く、型番や薬品名のような固有の言葉 に強い一方、「水を消毒したい」と「煮沸」のように、言い方が違うと見つけられない 弱点があります。
埋め込み検索(ベクトル検索)
もう一つは、文章を数百〜千個ほどの数の並び(埋め込みベクトル )に変換し、意味が近い文章ほどベクトルも近くなるようにする方法です。質問もベクトルにして、近いチャンクを探します。言い方が違っても意味が近ければ見つかります。
埋め込みを作るモデルには、手元の小さな計算機で動くものがあります。
ベクトルの近さを速く調べるには、MetaのFAISSや、SQLiteの拡張として動くsqlite-vec(2026年10月時点ではバージョン1未満の開発中)のようなライブラリが使えます。どちらもインターネット接続なしで動きます。
組み合わせる(ハイブリッド検索)
キーワード検索と埋め込み検索は得意なことが違うので、両方の結果を合わせて並べ直すのが実用的です。アカリでは、電力が乏しい日はキーワード検索だけ、晴れた日は埋め込み検索も使う、という切り替えをしています。
出典を示し、「わかりません」と言う
検索しただけでは、まだ半分です。RAGを信頼できる道具にするのは、次の三つの約束です。
根拠の範囲で答える :検索で見つかった文章に書かれていることだけを答えに使うよう、LLMに指示する。出典を示す :答えのどの部分がどの資料から来たかを表示し、人が原本を確かめられるようにする。見つからなければ答えない :検索結果の一致度が低いとき、「手元の資料にはありません」と返す。
三つめが特に大切です。RAGを使っても、LLMが見つかった文章を読み違えたり、資料にない内容を混ぜたりする可能性はなくなりません。だから出典を表示し、最後に確かめるのは人間 という分担を崩さないことが要になります。ハルの赤ペンは、仕組みができた後も工房の机に置かれたままです。
本棚を新しくする:スニーカーネット
RAGのもう一つの利点は、モデルを作り直さなくても知識を更新できる ことです。新しい資料をチャンクに切って索引に足せば、次の質問から使われます。
では、ネットのない世界で新しい資料をどう手に入れるか。答えは昔からあります。記録媒体を人が運ぶ のです。USBメモリやディスクを物理的に持ち運んでデータを移すことを、俗にスニーカーネット と呼びます。計算機科学者のアンドリュー・タネンバウムは1989年の教科書に「高速道路を突っ走る、テープを満載したステーションワゴンの帯域幅を侮るな」と書きました。数十GBのZIMファイルも、SSDに入れて歩いて届ければ、どんな回線より確実です。
運ぶときには、いつの版か を必ず記録します。古い資料と新しい資料で内容が食い違うとき、どちらを信じるかを判断する手がかりになるからです。
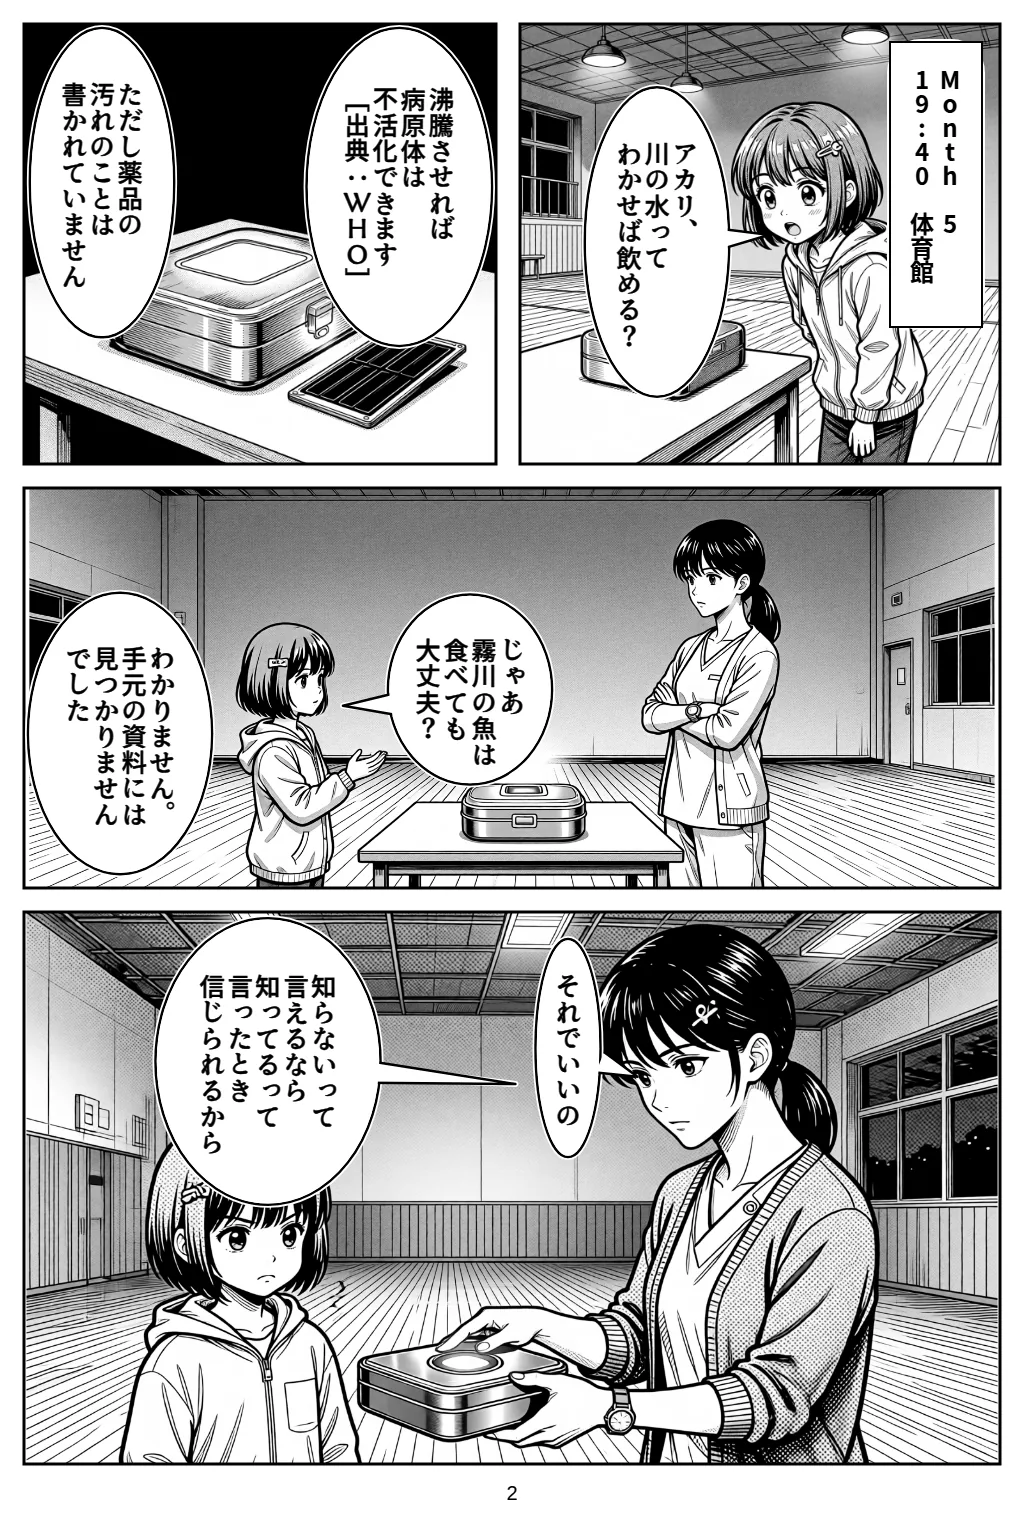
Month 5 19:40 体育館
完成した仕組みの最初の試験官は、小春だった。
「アカリ、川の水って、わかせば飲める?」
手元の資料では、こう書かれています。水をぐらぐらと沸騰させれば、病原性の細菌・ウイルス・原虫を不活化できます。[出典:WHO技術資料「Boil water」の要約]
「じゃあ、霧川の魚は食べても大丈夫?」
わかりません。手元の資料には、霧川の魚についての記述が見つかりませんでした。漁協の方か、川をよく知っている人に聞いてください。
小春は不満そうに口をとがらせた。けれど、隣で聞いていたハルは、アカリに向かって小さくうなずいた。あの夜から、初めてのことだった。
「それでいいの。知らないって言えるなら、知ってるって言ったときに信じられるから」
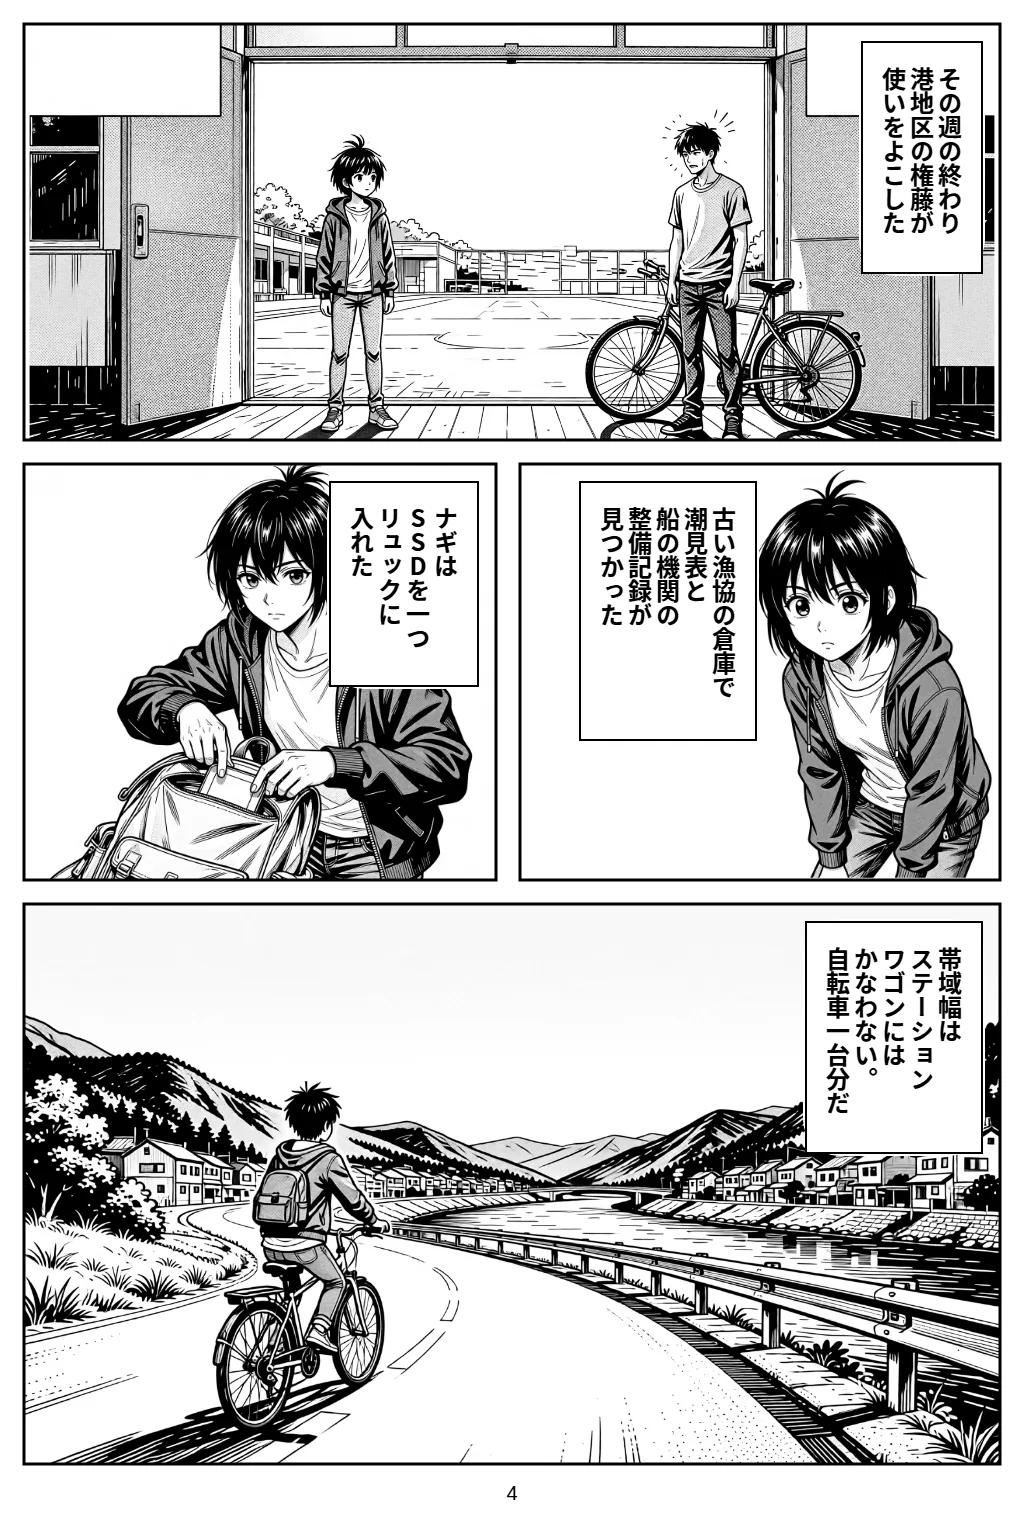
その週の終わり、港地区の権藤が使いをよこした。古い漁協の倉庫から、潮見表と船の機関の整備記録が見つかったという。ナギはSSDを一つ、リュックに入れた。帯域幅は、ステーションワゴンにはかなわない。自転車一台分だ。
この章で学んだこと
LLMの知識は重みの中に「にじんで」いて、根拠を示したり更新したりするのが苦手。RAGは答える前に外部の資料を検索し、それを根拠に生成する(Lewis ほか, 2020)。
2026年10月時点で、日本語版ウィキペディアのKiwix用ZIMは画像入りで29GB、画像なしで15GB。オフラインの本棚として十分に持ち運べる大きさ。
文書は出典付きのチャンクに分け、キーワード検索(BM25)と埋め込み検索を組み合わせて引く。小さな埋め込みモデルは手元の計算機でも動く。
信頼できるRAGの約束は三つ。根拠の範囲で答える、出典を示す、見つからなければ「わかりません」と言う。最後の確認は人間が担う。
モデルを作り直さなくても、資料を足せば知識は更新できる。ネットがなければ、記録媒体を人が運べばいい。
← 前の章 第9章 計画エンジン 次の章 → 第11章 教育と継承